Il tuo sito sparisce da Google a intervalli regolari e nessuno sa spiegarti perché? Non è sfortuna. A volte è scritto nel codice. Vediamo dove guardare.
Indice dei contenuti
Qualche tempo fa un collega SEO ha raccontato su Facebook una storia che vale più di un corso intero sull'indicizzazione. Un imprenditore gli chiede di dare un'occhiata al suo sito perché, parole sue, "ogni tre mesi Google mi banna dai risultati e devo pagare migliaia di euro all'anno al SEO che mi segue per farlo sistemare".
Google non banna nessuno ogni tre mesi con la regolarità di una bolletta. E infatti il problema non era Google. Era questa riga, nel template del sito:
<meta name="robots" content="<?php if ($cry != '') { echo 'noindex,nofollow'; } else { echo 'index,follow'; } ?>"/>Un noindex nascosto, con l'interruttore in mano a chi gestiva il sito.
Ti dico subito una cosa: storie come questa sono rare, e la stragrande maggioranza dei professionisti lavora onestamente. Ma il caso è perfetto per capire una cosa che riguarda tutti: un sito può dire a Google "non indicizzarmi" in tanti modi diversi, e alcuni non li vedi nemmeno aprendo il codice della pagina.
Cosa fa esattamente quella riga di codice?
Traduciamola in italiano, una parola alla volta.
- <meta name="robots" content="...">: è il meta tag robots, l'istruzione che il sito dà ai motori di ricerca. "index,follow" vuol dire "indicizzami e segui i miei link". "noindex,nofollow" vuol dire esattamente il contrario.
- $cry: è una variabile PHP (una specie di scatola in cui il programma tiene un valore). Il suo valore veniva assegnato in un altro file, abbastanza imboscato.
- if ($cry != ''): "se nella scatola c'è qualcosa".
- Il resto: se la scatola è piena, il sito scrive "noindex,nofollow". Se è vuota, scrive "index,follow".
In buona sostanza: basta scrivere un valore qualsiasi in un file che il proprietario non aprirà mai, e tutto il sito chiede a Google di essere tolto dai risultati. Google obbedisce (il noindex è una delle poche direttive che rispetta sempre), le pagine escono dall'indice nel giro di qualche giorno o settimana, il traffico crolla. Il cliente chiama in preda al panico, il "tecnico" svuota la scatola, il sito torna su. Fattura. Tre mesi dopo, si ricomincia.
È il meccanico che ogni volta che porti la macchina al tagliando ti allenta un bullone, così fra tre mesi torni da lui. Con la differenza che la macchina almeno fa rumore. Un noindex no: è silenzioso, e te ne accorgi solo quando il telefono smette di squillare.
Il SEO deve saper programmare?
Il post del collega partiva proprio da qui: la vecchia discussione "un SEO deve saper programmare sì o no".
Secondo me la risposta onesta è: non deve saper scrivere un gestionale, ma deve saper leggere il codice. Quanto basta per aprire un template, riconoscere un if, capire che una variabile cambia il comportamento della pagina e chiedersi "e questa da dove arriva?". Non serve un ingegnere. Serve qualcuno che non si fermi alla superficie.
E qui arriviamo al punto pratico: dove si può nascondere un noindex, e come lo trovi.
Dove si nasconde un noindex? I sette posti da controllare
Quando il sito non è indicizzato, o perde pagine dall'indice senza un motivo apparente, queste sono le zone da ispezionare. Le metto in ordine di frequenza: dalle sviste più banali ai trucchi più cattivi.
1. Il meta tag robots nel codice della pagina
Il caso classico. Apri la pagina, tasto destro → "Visualizza sorgente pagina" (oppure Ctrl+U, Cmd+Option+U su Mac) e cerca "robots" con Ctrl+F.
Se trovi noindex, hai già il colpevole. Se non lo trovi, non hai ancora finito: è solo il primo posto.
2. L'impostazione di WordPress dimenticata accesa
In WordPress c'è una casella che fa più danni di tanti hacker: Impostazioni → Lettura → "Scoraggia i motori di ricerca dall'effettuare l'indicizzazione di questo sito". Si spunta durante lo sviluppo, per non far finire il sito in costruzione su Google. Poi il sito va online e nessuno si ricorda di toglierla.
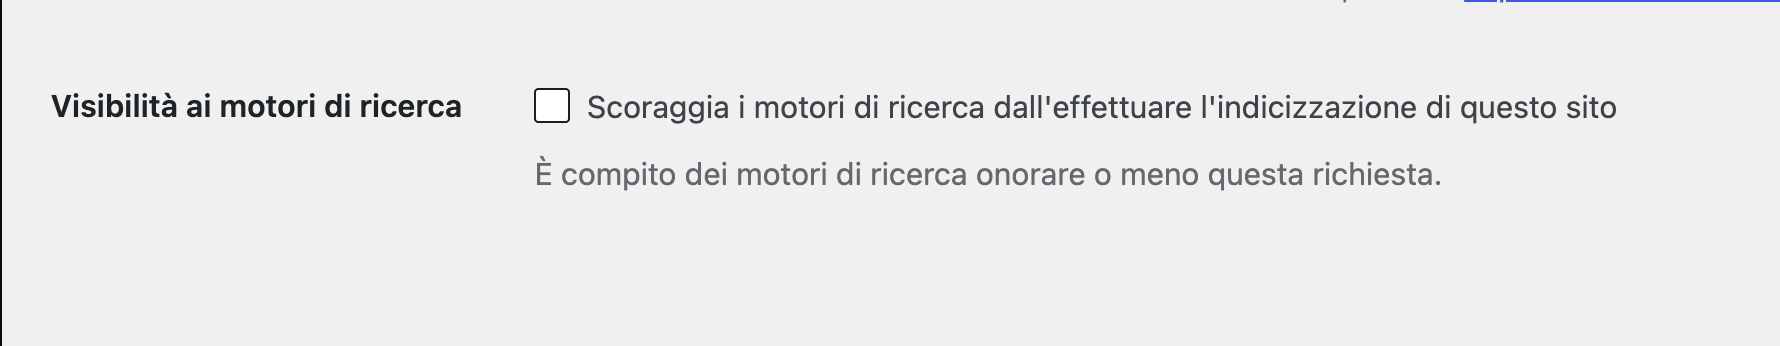
Il risultato è un noindex su tutto il sito. Nessuna malizia, solo distrazione. Ma l'effetto è identico a quello della variabile $cry.
3. Le impostazioni del plugin SEO
Yoast, Rank Math e compagnia permettono di mettere in noindex intere tipologie di contenuto: articoli, pagine, categorie, tag, prodotti. Mettere in noindex i tag o gli archivi per autore è spesso una scelta sensata. Mettere in noindex "Pagine" o "Prodotti" per sbaglio, molto meno.
Controlla le impostazioni generali del plugin, ma anche la singola pagina: nel box SEO sotto l'editor c'è quasi sempre una voce tipo "Consenti ai motori di ricerca di mostrare questa pagina nei risultati?".
4. L'header HTTP X-Robots-Tag
Qui le cose si fanno interessanti. Il noindex non deve per forza stare nell'HTML: il server può mandarlo come header HTTP (le informazioni che il server spedisce al browser prima della pagina vera e propria, e che non vedi nel sorgente). Si chiama X-Robots-Tag e Google lo rispetta esattamente come il meta tag.
Può essere impostato dal file .htaccess con una riga del genere:
Header set X-Robots-Tag "noindex, nofollow"Se vuoi capire meglio come funziona quel file, trovi tutto nella guida pratica all'.htaccess.
Come lo vedi? Dagli strumenti per sviluppatori del browser: F12 → scheda "Network" (o "Rete"), ricarica la pagina, clicca sulla prima richiesta e guarda le intestazioni di risposta. Oppure, se non hai paura del terminale:
curl -I https://www.tuosito.it/Hai bisogno di una consulenza SEO urgente?
Se tra le righe che escono c'è x-robots-tag: noindex, hai trovato il problema. E puoi guardare il sorgente della pagina per tutta la vita senza vederlo.
5. Il robots.txt (che fa il contrario di quello che pensi)
Il robots.txt è il file che dice ai motori di ricerca quali parti del sito non devono scansionare. Un Disallow: / blocca la scansione di tutto il sito, ed è un errore che si vede spesso dopo il passaggio da un sito di prova a quello definitivo.
Attenzione però a un dettaglio che confonde anche chi lavora nel settore: il robots.txt blocca la scansione, non l'indicizzazione. Se una pagina è bloccata dal robots.txt, Google non la legge. E se non la legge, non vede nemmeno il noindex che c'è dentro.
Risultato paradossale: chi vuole togliere una pagina da Google mette sia il noindex sia il Disallow nel robots.txt, e la pagina resta nei risultati, magari senza descrizione. In Search Console la trovi come "Indicizzata, ma bloccata da robots.txt". Se vuoi che Google veda il noindex, deve poter scansionare la pagina.
6. Il canonical che punta altrove
Non è un noindex, ma ci va vicino. Il tag canonical dice a Google "la versione originale di questa pagina è quest'altra". Se tutte le pagine del sito hanno un canonical che punta alla home, o a un dominio diverso (succede dopo migrazioni fatte male o con temi copiati da un altro sito), Google tende a indicizzare l'altra versione e a ignorare la tua.
Lo trovi nel sorgente cercando rel="canonical". Deve puntare alla pagina stessa, o a una sua versione davvero equivalente.
7. Il noindex condizionale: quello che il tuo browser non vedrà mai
Ed eccoci al livello del collega con la variabile $cry. Il noindex compare solo a certe condizioni:
- Una variabile impostata in un file nascosto, come nel caso raccontato.
- Una data: dopo un certo giorno, o in certi mesi.
- Lo user agent (il "nome" con cui un programma si presenta al server): il sito mostra la pagina normale a te e il noindex solo a Googlebot. Tu controlli il sorgente e trovi "index,follow". Google trova l'opposto.
- Un JavaScript che aggiunge il meta tag dopo il caricamento della pagina. Nel sorgente (Ctrl+U) non c'è, ma Google la pagina la renderizza (cioè la "esegue" come un browser) e lo vede.
Quest'ultimo gruppo è il più subdolo, perché tutti i controlli fatti "da utente" danno esito negativo. E il proprietario si sente dire: "il codice è pulito, è Google che ce l'ha con noi".
Come verifichi cosa vede davvero Google?
C'è un solo testimone affidabile: Google stesso. Lo interroghi da Search Console.
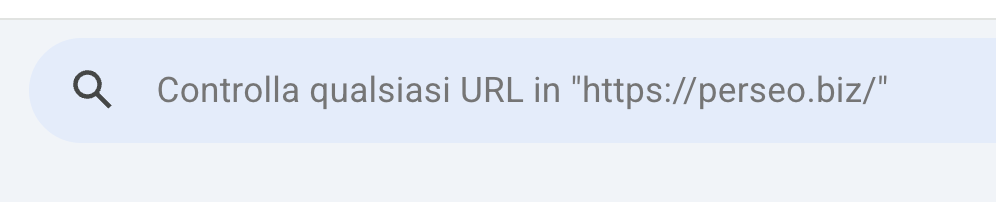
- Apri Search Console e incolla l'indirizzo della pagina nella barra in alto, quella con scritto "Controlla qualsiasi URL in…".
- Clicca su "Testa URL live". Google scarica la pagina in quel momento, come farebbe Googlebot.
- Guarda la voce "Indicizzazione consentita?". Se c'è scritto no, ti dice anche perché (tag noindex, header, robots.txt).
- Clicca su "Visualizza pagina sottoposta a scansione" → scheda "HTML". Questo è l'HTML che ha ricevuto Google, già renderizzato. Cerca "robots" e "canonical" lì dentro.
- Nella stessa finestra c'è "Ulteriori informazioni" → "Risposta HTTP": qui vedi gli header, X-Robots-Tag compreso.
Perché insisto su questo strumento? Perché un trucco basato sullo user agent può ingannare il tuo browser, e anche un crawler come Screaming Frog impostato per presentarsi come Googlebot: alcuni script controllano l'indirizzo IP di chi chiede la pagina, non solo il nome. Il test live di Search Console parte dai server di Google. Lì non si scappa.
Per avere il quadro di tutto il sito, invece, vai su Indicizzazione → Pagine e guarda i motivi di esclusione. Se la voce "Esclusa in base al tag 'noindex'" contiene pagine che dovrebbero stare su Google, sai da dove partire.
E se vuoi un controllo a tappeto, Screaming Frog (anche la versione gratuita, fino a 500 URL) ha la colonna "Indexability" e la scheda "Directives", che riassumono meta robots, X-Robots-Tag e canonical pagina per pagina.
Hai trovato il noindex ma non sai da dove arriva?
Se Search Console conferma il noindex ma nel pannello di WordPress e nel plugin SEO è tutto in ordine, vuol dire che qualcosa nel codice lo sta aggiungendo. A quel punto si va a cercare nei file.
Attenzione: prima di toccare qualsiasi cosa, fai un backup completo di file e database. Sempre. Non è un consiglio, è una regola.
Se hai accesso ai file del sito via SSH, una ricerca come questa dentro la cartella del sito ti mostra in quali file compare la parola "noindex":
grep -rn "noindex" wp-content/Ne troverai diversi, soprattutto dentro i plugin SEO: è normale, è il loro mestiere. Quelli da guardare con sospetto sono nel tema, in plugin che non conosci, o in file dai nomi anonimi. Se non hai SSH, molti hosting hanno un file manager con la ricerca nel contenuto dei file, oppure scarichi tutto via FTP e cerchi con un editor come VS Code.
Altre cose da guardare:
- Il file functions.php del tema (e del tema child, se c'è): è il posto preferito per aggiungere codice che "agisce di nascosto" su tutto il sito.
- La cartella mu-plugins (wp-content/mu-plugins): i plugin che stanno lì si attivano da soli e non compaiono nella normale lista dei plugin. Se esiste e non sai cosa c'è dentro, fatti delle domande.
- Codice offuscato: righe con base64_decode, eval o stringhe lunghissime di caratteri senza senso. Non sempre sono malevole, ma nel tema di una PMI di solito non hanno motivo di esistere.
- Il file .htaccess, per l'header X-Robots-Tag di cui parlavamo sopra.
Un'ultima cosa. Un noindex inserito di nascosto non è sempre opera del fornitore: può arrivare da un tema o un plugin "nullato" (la versione craccata di un prodotto a pagamento, scaricata da siti poco raccomandabili) o da un attacco informatico. Prima di accusare qualcuno, quindi, raccogli i fatti: in che file sta il codice, da quando c'è (la data di modifica del file è un buon indizio), chi aveva accesso al sito. E se ti servono, conserva una copia del file così com'era.
Come eviti di ritrovarti nella stessa situazione?
Non serve diventare programmatori. Bastano tre abitudini.
- Gli accessi devono essere tuoi: hosting, dominio, Search Console, Google Analytics. Il fornitore lo aggiungi come utente, non gli lasci in mano le chiavi di casa. Il giorno che cambi consulente, non devi chiedere il permesso a nessuno.
- Search Console attiva e con le email abilitate: quando le pagine escluse per noindex aumentano di colpo, Google te lo segnala. Basta leggere quelle email invece di archiviarle.
- Un controllo periodico, anche solo una volta al mese: il report Indicizzazione → Pagine e un test live sulla home e sulle due o tre pagine che ti portano più contatti. Dieci minuti.
E se un fornitore ti dice che "Google ti banna ogni tre mesi", chiedigli quale sia il motivo scritto in Search Console. Google, quando esclude una pagina, il motivo lo scrive sempre.
Un buon meccanico la macchina te la restituisce che va. E se ogni tre mesi si rompe lo stesso bullone, forse non è colpa del bullone.