I casi studio SEO più problematici che mi siano mai capitati e come li ho risolti
Indice dei contenuti
Sito estero – Blocco Paypal
In più di 10 anni di attività, mi sono capitate, ovviamente, alcune sfide. Alcune grosse, altre di meno. All'inizio non ci capivo niente e avevo più difficoltà, poi con l'abitudine e il ripresentarsi di medesimi errori, c'ho fatto il callo, come tutti.
Il caso studio è questo
Sito estero, abbastanza grosso, con molte pagine sia di prodotti che di servizi (offerte di lavoro, collaborazioni ecc…).
Sulla Search Console appaiono una caterva di pagine non scansionabili e, di conseguenza, non indicizzabili. Le pagine del blog non hanno problemi, infatti il traffico arriva tutto da lì. Ma quelle relative agli acquisti, ovviamente 0.
Nella mia ingenuità penso "Visto che il sito è in React, mi gioco tutto che è un problema di Server-Side Rendering." E avrei perso tutto, dato che Wappalyzer mi segnala che il portale ha Next.js: framework che permette una serie di operazioni SEO in React.
Voglio una conferma e da "Visualizza sorgente pagina", l'html si legge tutto. Titoli, link, paragrafi, immagini.
"Ok, quindi non può essere questo il problema" (anche perché sarebbero stati bloccati gli articoli del blog, a quel punto). Chiedo aiuto alla nostra vecchia rana (Screaming Frog), dove, in effetti, segnala una sfilza di pagine bloccate dal robots.txt. Sono tutte quelle di "acquisto". Ci siamo!
Vado sul robots, dove mi aspetto di trovare i path in disallow, ma è tutto libero. Pure troppo. È tutto in Allow. Non è possibile! Tiro giù qualche Madonna e comincio a leggere meglio i dati di Screaming Frog. Noto che nei dettagli c'è un link paypal che causa il blocco.
C'è qualcosa che non va esternamente. Comincio a cercare qualcosa "sull'Internet" e in un forum legato a paypal, c'è un utente che aveva avuto il mio stesso problema e che il blocco, secondo lui, era dovuto ai CORS.
I CORS (Cross-Origin Resource Sharing) sono un sistema di sicurezza del browser che impedisce che uno o più script in una pagina web, effettuino richieste verso un dominio diverso dal proprio, a meno che il server di destinazione non permetta esplicitamente tali richieste. Se PayPal non consente l'accesso alle sue risorse da parte di un dominio, le risorse non vengono caricate, causando problemi di funzionamento o visualizzazione sul sito.
Ok forse ci sono!
Mi metto in contatto con l'assistenza ufficiale di Paypal spiegando il problema e mi dicono che sarò ricontattato a breve.
Ovviamente, mi aspettavo una risposta tipo "Sì, in effetti il sito del cliente è visto come malevolo da Paypal e quindi le pagine dove c'è il sistema di pagamento sono bloccate". Invece mi dicono che il sito è tutto ok e non è in alcuna "black list".
"Com'è possibile?" Però forse c'è una logica. Se c'è un blocco tra i browser, dovrebbero esserci problemi di visualizzazione o errori 500, 503 et similia non appena le persone tentano di effettuare un pagamento. Search Console me le avrebbe restituite con questo status code o al massimo in 404. Mi sa che sono sulla strada sbagliata.
Finalmente forse la luce della ragione (LA BAAAAANDA – cit. Blues Brothers):
Dunque, se Screaming Frog segnala che le pagine sono bloccate dal robots.txt, ma in realtà il file è completamente aperto, non è che il problema è su PayPal? Controllo ed ecco la risposta: il link PayPal contenuto nel sito, include un percorso che è in Disallow nel robots.txt di PayPal stesso.
Finalmente tutto ha senso.
Segnalo il problema al cliente e gli invio una guida ufficiale su come aggirarlo, modificando il link in tutte le pagine coinvolte, rispettando i criteri di PayPal.
Com'è andata a finire?
Qualche tempo dopo lascio l'agenzia che mi aveva affidato questo cliente estero e, per curiosità, controllo qualche giorno fa come va il tutto: quelle pagine sono ancora bloccate. 😅 Grazie a questo errore, il sito, ancora oggi, perde una marea di soldi al giorno.
Sito di informazione – Problema principale: thin content
Infatti molte news non venivano indicizzate. Cominciamo a pubblicare news lunghe, formattate per la SEO (headings, link interni ed esterni, tag alt ecc…), dettagliate, esaustive e alcune, addirittura, escono prima dei competitor. Cresciamo sulla ricerca organica, ma c'è qualcosa che blocca l'aumento di visite.
Vado sulla Search Console e mi accorgo che c'è un numero spropositato di pagine scansionate, ma non indicizzate. Il povero crawler stava faticando assai. Scansionare URL spazzatura non è bello, anche tag non pertinenti del vecchio sito, quando era in WordPress (ora è in un CMS proprietario). Bisogna bloccare questo sistema disfunzionale.
"Vabbè, ma vanno poi tutte in 404, che te frega?! poi Google le elimina" mi dicono. Il fatto è che stavano aumentando di giorno in giorno.
Rifletti, analizza e vai a beccare che all'interno della sitemap_index, ci sono 2 sitemap. "Mi sta bene" penso io. Ci sono tantissimi articoli ed è corretto che anche prima dei 50k URL, si crei una seconda sitemap per non appesantire tutto il sito in una sola. Dopo un paio di giorni, ritorno sulle 2 sitemap e vedo che hanno gli stessi URL. Sono identiche. Una la copia dell'altra.
Immediatamente faccio rimuoverne una e… tac. Lo spider sembra che torni finalmente a respirare. Così, questo intervento tecnico, insieme agli ottimi e autorevoli articoli che ormai popolano la testata, hanno fatto sì che il sito cominciasse a crescere sul serio.
Molte persone credono che basti un tag title, un H1 o H2 per far riprendere un sito. Molti addirittura dicono "sì sì abbiamo la SEO sul sito. c'è già Yoast". Ah tutto qui? Avete risolto tutto? Come si può ben vedere, la SEO è un mix perfetto di strategie, psicologia del target, tecniche (a volte complesse) e contenuti. Come tutte le cose, è un insieme di fattori esterni e interni. E soprattutto non è un'attività che può cambiarti la vita da un giorno all'altro (ho cominciato a seguire questo cliente da giugno, più o meno dov'è la freccia rossa).

Azienda di infissi – Il blog sparito con il rifacimento del sito
Un'azienda che vende infissi arriva da noi disperata: i contatti di chi ha bisogno di una porta, di una finestra o di infissi nuovi non arrivano più. Il sito è stato appena rifatto ed è pure bello. Solo che non porta più nessuno.
Il caso studio è questo
Apriamo Search Console, partiamo con l'analisi e scopriamo il problema: tutti gli articoli del blog sono andati perduti. Se li è persi per strada il webmaster che ha lavorato al rifacimento.
Di solito, in questi casi, il colpevole è un redirect 301 mancante (quello che dice a Google "questa pagina è stata spostata definitivamente qui"). Qui i redirect mancavano, certo, ma il problema era a monte: non c'era più una pagina verso cui farli puntare. Non esisteva nemmeno la sezione blog. Zero.
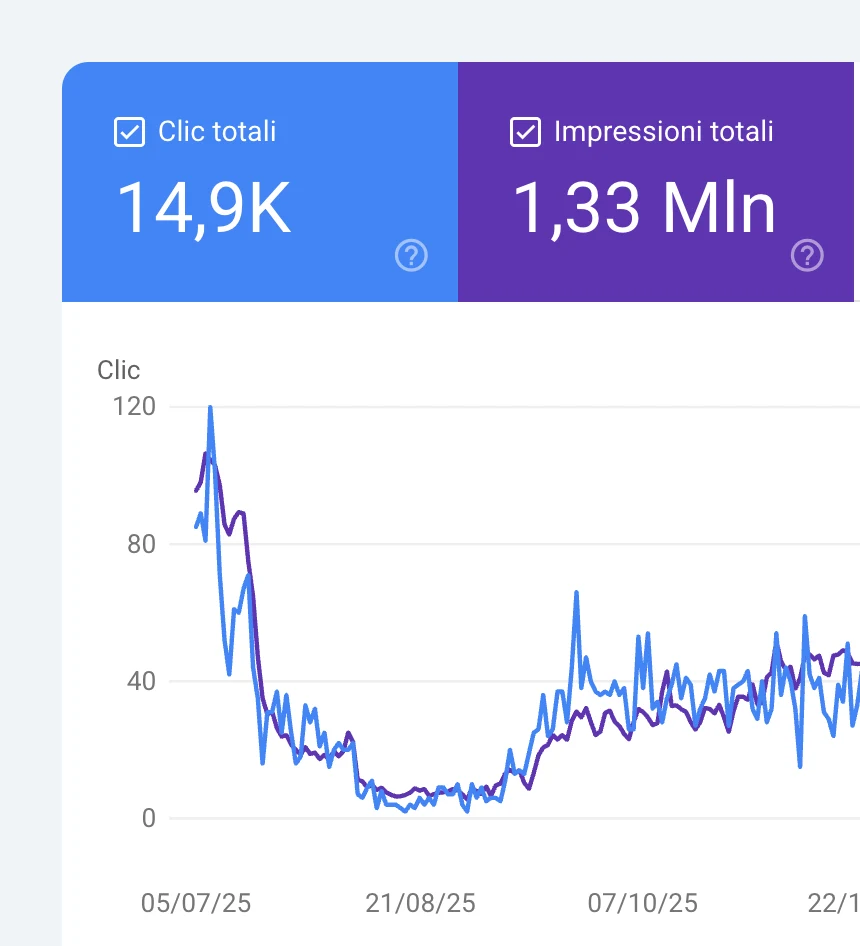
In buona sostanza, un'azienda che vende porte aveva murato quelle da cui entravano i clienti. Il grafico di Search Console non ha bisogno di tante spiegazioni: da inizio luglio 2025, con giornate tra gli 80 e i 120 clic, si scende in poche settimane fino a una manciata di clic al giorno.
Cosa abbiamo fatto
Se gli articoli non ci sono più, bisogna andare a riprenderli dove sono rimasti. A quel punto ci siamo rivolti a Wayback Machine (l'archivio di Internet Archive che conserva le copie storiche dei siti). Abbiamo portato in locale le copie archiviate del vecchio sito e scritto uno script Python che, per ogni articolo:
- cerca il file HTML dell'articolo nella copia locale;
- sceglie lo snapshot più recente disponibile (lo snapshot è la "fotografia" della pagina in una certa data);
- estrae titolo e contenuto, e ricava la data dallo snapshot;
- ricava slug (la parte finale dell'URL) e categoria dal percorso originale;
- genera un file WXR (il formato XML con cui WordPress importa ed esporta i contenuti), pronto per l'importazione.
Detta così sembra una passeggiata. O meglio: lo sembra finché non lanci lo script.
- I percorsi di Wayback: le cartelle degli snapshot hanno come nome un timestamp seguito da "id_" e la struttura delle sottocartelle cambia. Lo script doveva fare i conti con le varianti https://, http:// e www, e con una modifica alla ricerca siamo passati direttamente a zero risultati.
- Il contenuto: nelle prime prove non veniva importato correttamente. Ottimo, un articolo senza articolo.
- Lo slug: quando l'estrazione dal percorso falliva, il contenuto arrivava, ma lo slug diventava "articolo" e la categoria "Blog". Ed è l'errore più subdolo, perché a occhio sembra tutto a posto. Se l'URL non è quello di prima, però, non stai recuperando un vecchio articolo: ne stai pubblicando uno nuovo, che Google non ha mai visto.
Per questo la regola è stata una sola: prima un articolo, poi tutti gli altri. Si importa il primo in WordPress, si controllano contenuto, slug e categoria, e solo dopo si passa al resto. Per il primo articolo lo script ha trovato 6 snapshot e ha scelto quello del 24 giugno 2025: l'ultima fotografia di una porta, poco prima che venisse murata. Alla fine gli articoli li abbiamo recuperati tutti, e il blog è tornato online.
Com'è andata
In Search Console la risalita si vede da settembre 2025: si torna intorno ai 40 clic al giorno, con punte tra i 50 e i 60. Su tutto il periodo fanno 14,9K clic e 1,33 milioni di impressioni. Lo stesso film su SEOZoom: l'andamento del dominio crolla da circa 3,5K a meno di 500 tra luglio e settembre 2025, poi risale fino a circa 3K a inizio 2026.
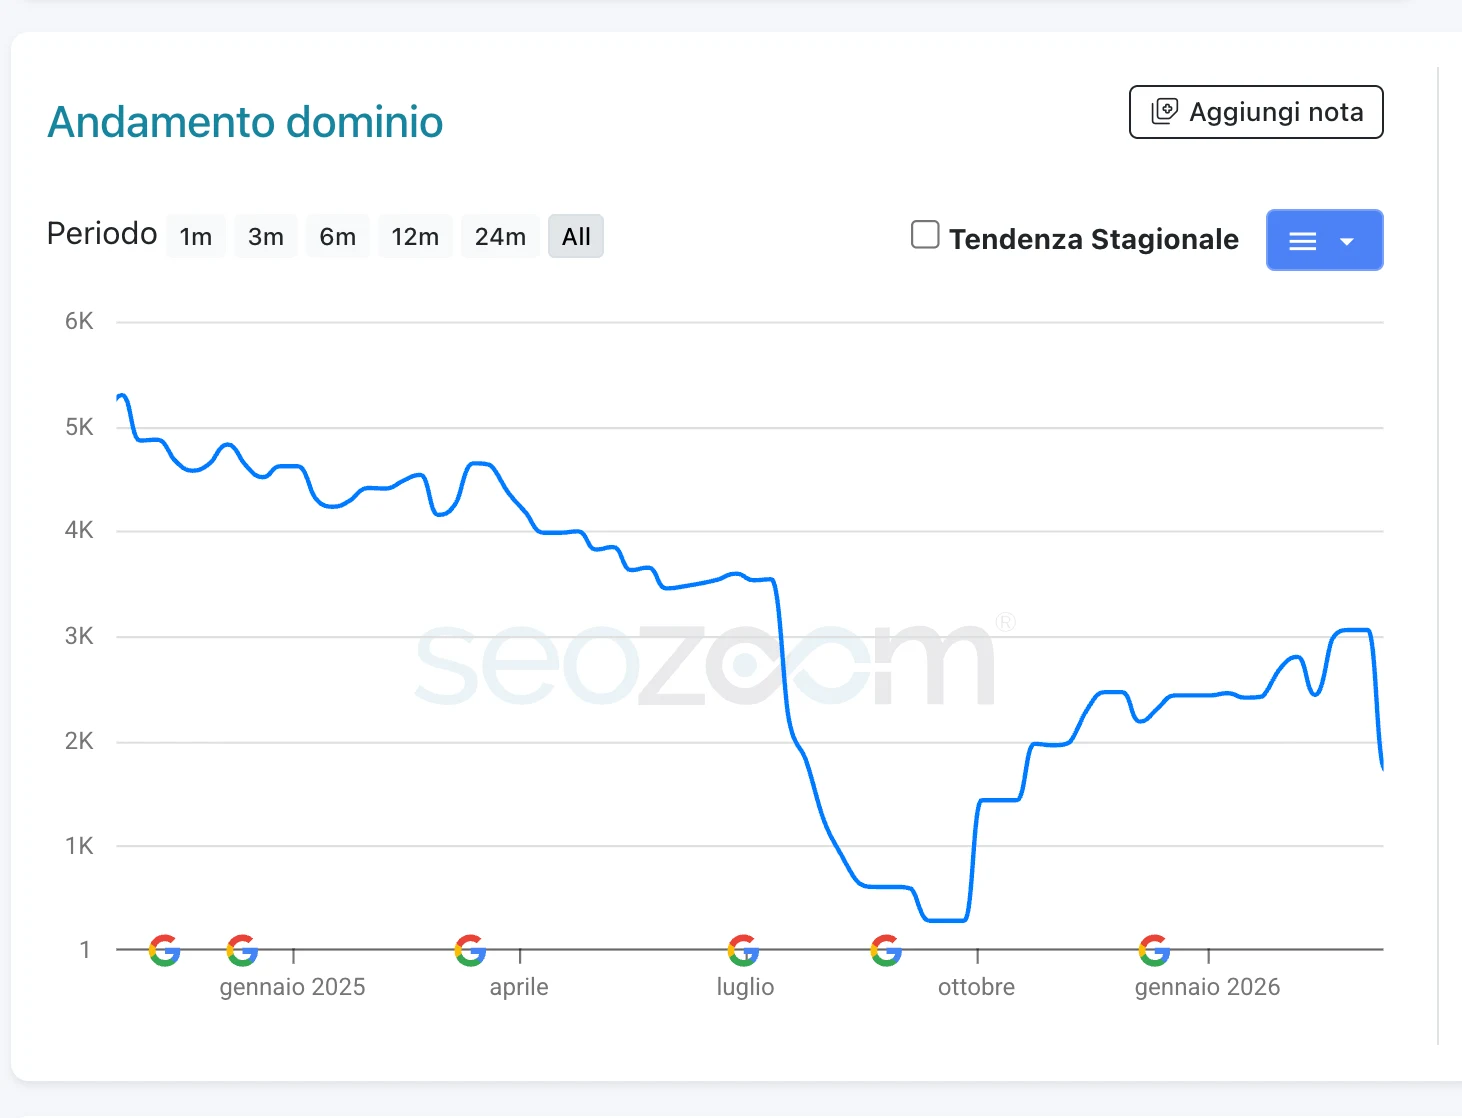
Ora, onestà prima di tutto. I clic non sono tornati ai picchi di luglio. Il dominio, su SEOZoom, era già in calo da prima del rifacimento. Nello stesso periodo il grafico segna anche degli aggiornamenti di Google, quindi non tutto si può attribuire al nostro lavoro. E l'ultimo tratto riscende sotto i 2K: non l'ho tagliato, perché un sito recuperato non è un sito guarito per sempre.
Cosa ci porto a casa
- Prima di rifare un sito, fai l'inventario: esporta tutti gli URL e guarda in Search Console quali pagine portano traffico. Sono quelle che non puoi perdere, e anche quando restano online vanno modificate con calma.
- I redirect non bastano se manca la destinazione: prima si controlla che i contenuti esistano ancora, poi si pensa a dove mandarli.
- Wayback Machine salva, ma è l'ultima spiaggia: recuperare a mano quello che bastava non cancellare costa molto più di un backup. Sempre. Non è un consiglio, è una regola.
- Prova su un articolo solo: importarne cento con lo slug sbagliato significa rifare il lavoro cento volte.
Il sito nuovo era bellissimo, per carità. Mancavano solo le porte.
Azienda enogastronomica – Prodotto stagionale: l'intento che mancava
Questo non è un caso problematico, anzi. Ma insegna una cosa che vedo sbagliare di continuo: cercare di capire cosa cerca davvero la gente, prima di scrivere.
Il caso studio è questo
Un'azienda del settore enogastronomico che vende un prodotto stagionale. Il sito ha già dei contenuti informativi che portano traffico, ma più o meno sempre gli stessi: qualche decina di visite al giorno, con picchi quando il periodo si avvicina.
Apro SEOZoom per vedere per quali ricerche il sito è visibile e per quali no. Il quadro è chiaro in dieci minuti: quasi tutte le keyword sono informazionali (chi vuole capire, informarsi, confrontare). Gli intenti transazionali, quelli di chi sta per comprare o vuole sapere quanto spenderà ("costo", "prezzo 2026" e simili), sono quasi assenti. Zero.
Ed è un problema, perché in un prodotto stagionale chi cerca il prezzo è chi ha già deciso di comprare. Ha un'urgenza, e il periodo è breve. Se in quella finestra non ci sei, ci sono gli altri.
Cosa ho fatto
Un solo contenuto, pensato apposta per quel buco: un articolo sul prezzo del prodotto nel 2026, che risponde alla domanda che le persone si fanno davvero ("quanto costa quest'anno?") invece di girarci intorno.
Com'è andata
Dalla pubblicazione dell'articolo, il sito è passato da circa 30 clic al giorno a quasi 300. Nel grafico qui sotto (Search Console, da fine luglio a metà ottobre 2026) si vede bene: una linea piatta per due mesi e poi la verticale. Nel periodo: 2,85K clic e 126K impressioni, con una posizione media di 9,8.
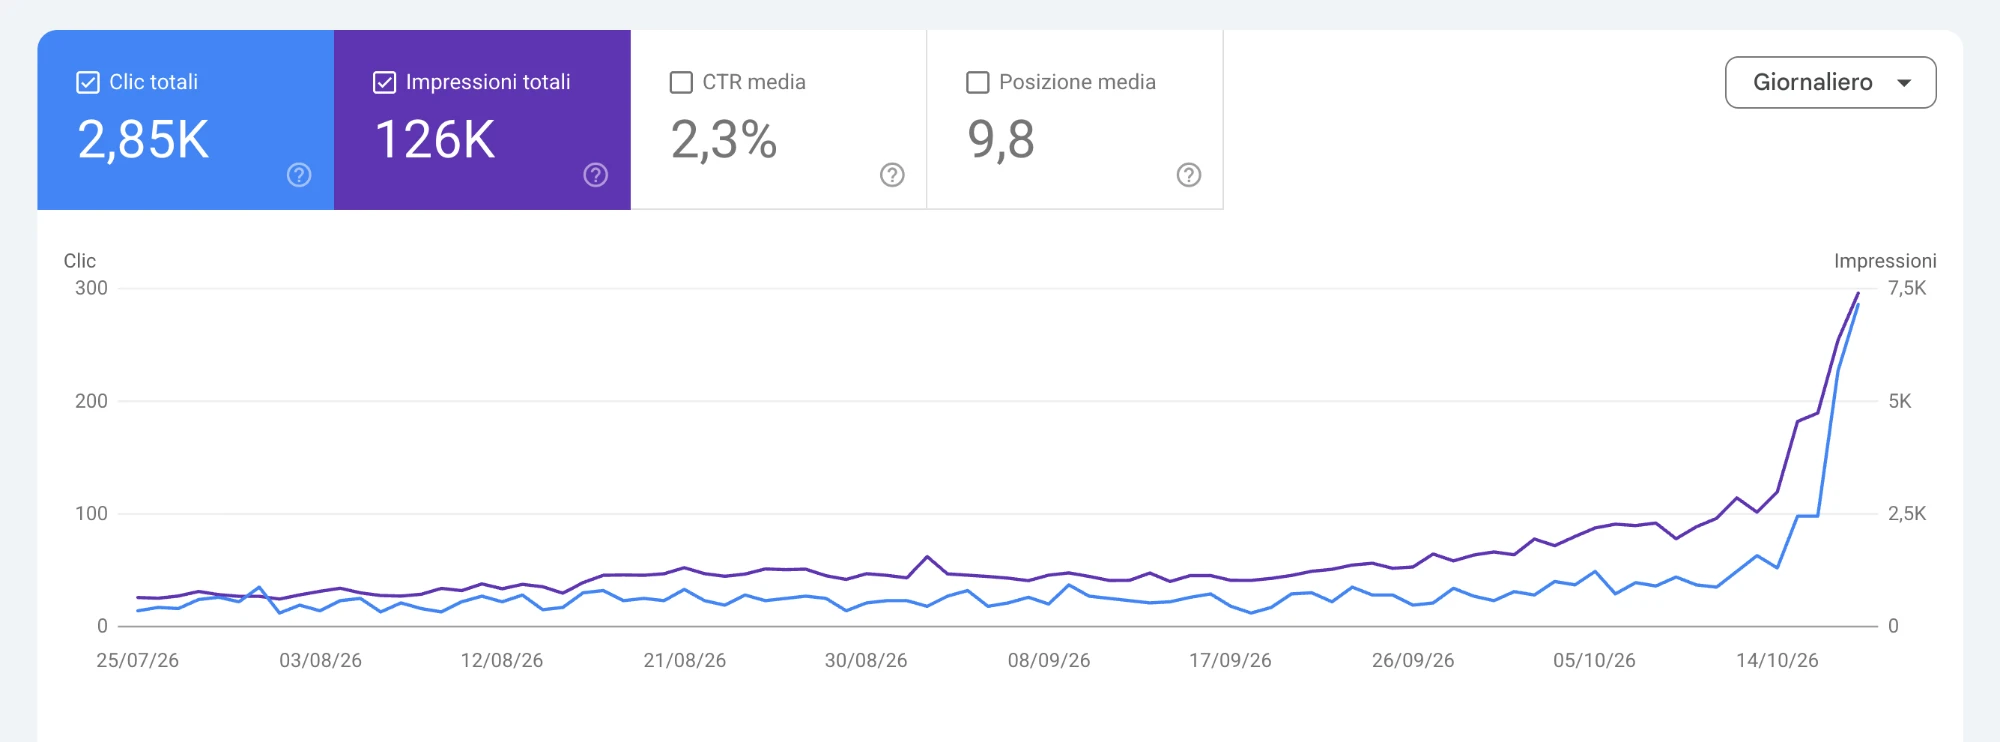
Ora, onestà prima di tutto: non è tutto merito dell'articolo. Il periodo di vendita sposta la domanda da solo, e le keyword legate al prodotto salgono comunque in autunno, con o senza contenuti. Ma è proprio qui che il caso diventa interessante: senza quell'articolo avremmo avuto circa il 50% di visite in meno. La stagionalità ha alzato la marea, l'articolo ci ha messo la barca che raccoglieva la parte di domanda che prima restava a riva.
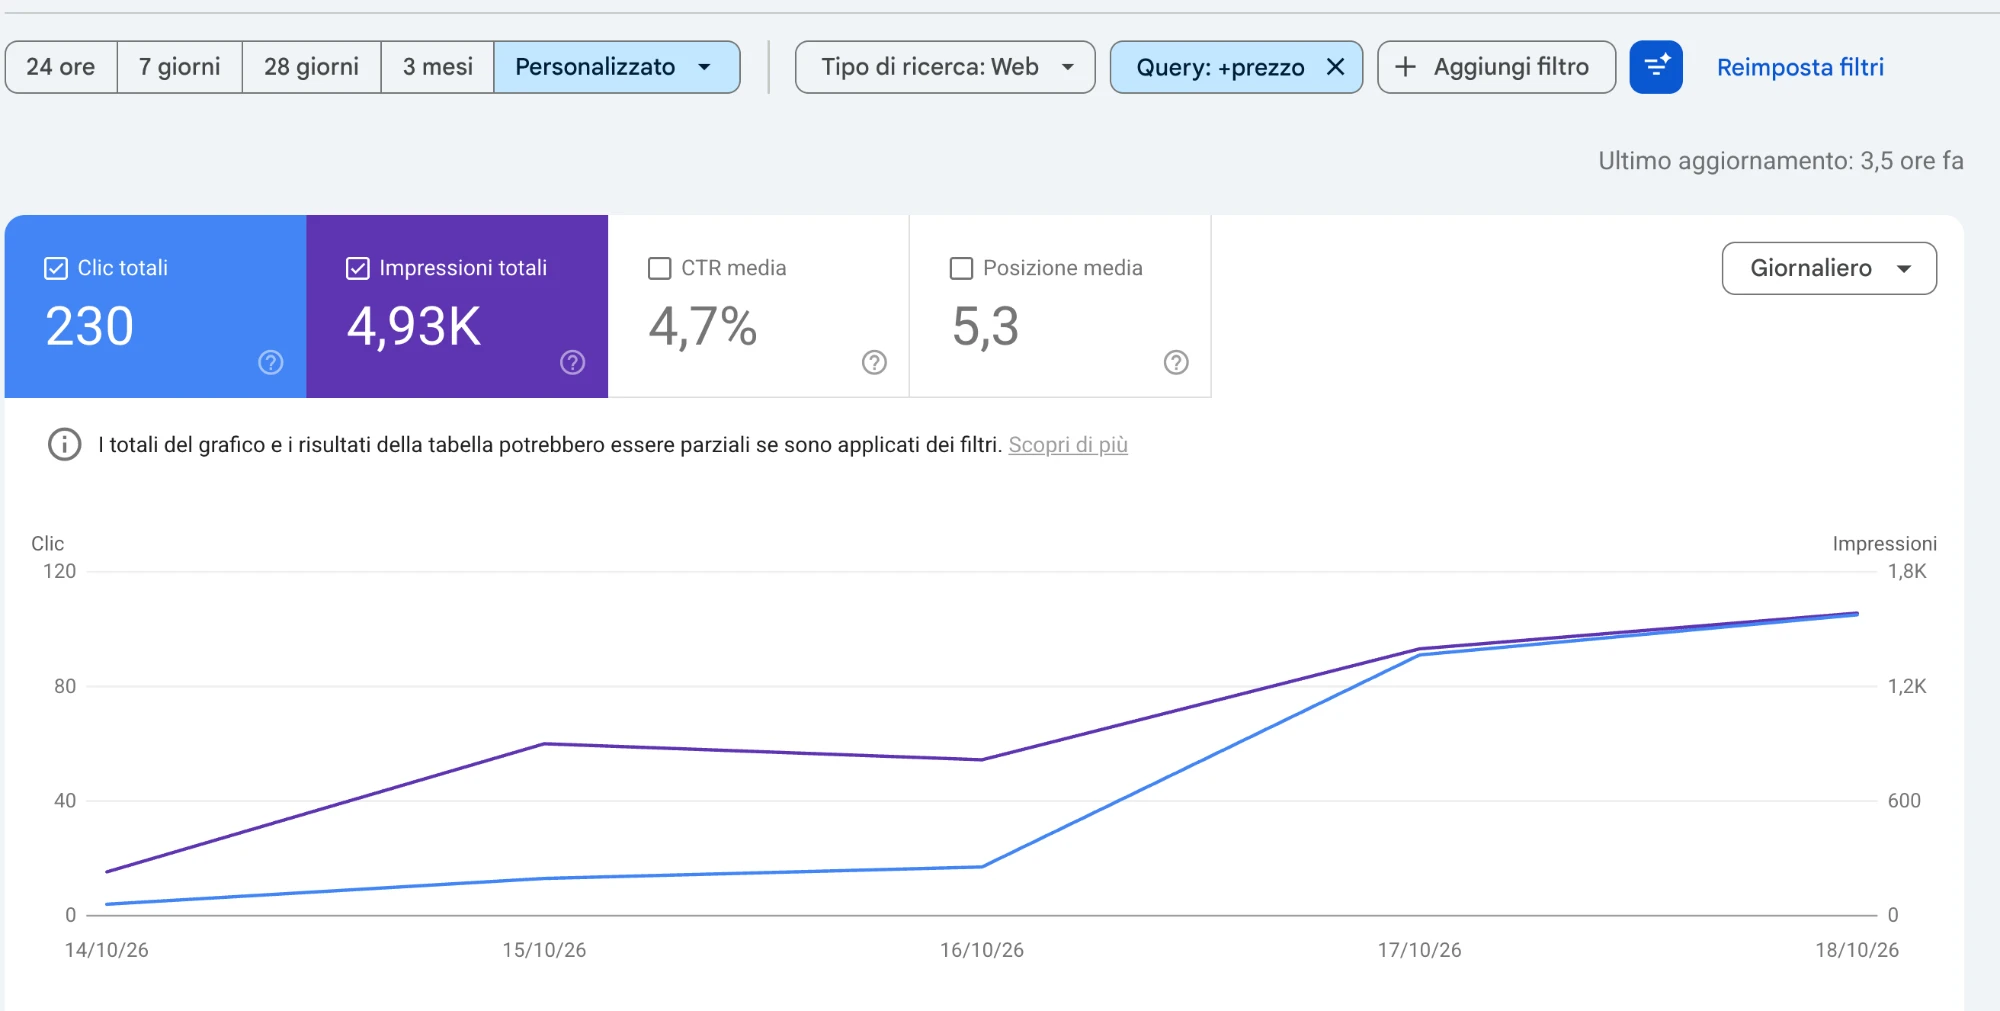
Il dato che mi convince di più è quello sulle query che contengono la parola "prezzo", cioè proprio gli intenti che prima mancavano. Filtrando Search Console su quella parola, tra il 14 e il 18 ottobre: 230 clic, 4,93K impressioni, CTR del 4,7% e posizione media 5,3. E guarda la curva: parte da pochi clic al giorno e il 18 ottobre ne porta oltre 100, su un totale di 286 clic quel giorno (7,4K impressioni). In altre parole, una fetta enorme dell'impennata arriva da ricerche che prima non intercettavamo affatto.
Cosa ci porto a casa
- Guarda gli intenti, non solo i volumi: un sito pieno di contenuti informativi può essere invisibile proprio dove si decide l'acquisto.
- Nei prodotti stagionali conta il tempismo: il contenuto transazionale va pubblicato prima del picco, non durante. Vale anche per le keyword a tempo determinato.
- Separa sempre cosa fa il mercato da cosa fai tu: se non lo fai, ti attribuisci meriti che non hai, o peggio ti dai colpe che non hai.
A volte non serve scrivere di più. Serve scrivere quello che manca.
Vuoi avviare una collaborazione duratura?
Inviami una email personalizzata